
Unicode编码解码
Unicode编码解码介绍
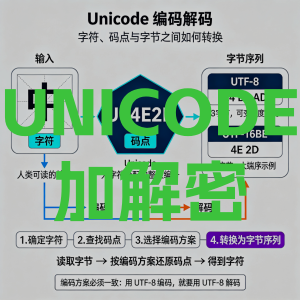
Unicode(统一码、万国码)是计算机领域的一项字符编码标准,目标是为世界上每一种文字系统中的每个字符分配唯一的编号(码点),让不同语言、不同平台的系统能够用同一套编码交换文本。我们日常使用的每个汉字、字母、标点乃至 emoji 表情,在 Unicode 中都有一个对应的编号,例如"中"的码点是 U+4E2D,"😀"的码点是 U+1F600。
Unicode 编码常见的写法有三种:一是 \uXXXX 转义序列,广泛用于 JavaScript、Java 等编程语言,中文会被写成 \u4e2d\u6587 的形式;二是 &#xXXXX; 十六进制 HTML 实体;三是 &#XXXXX; 十进制 HTML 实体,后两种多出现在网页源码中。本工具支持三种格式的相互转换,编码时可选择只转换中文等非 ASCII 字符,也可以连同英文数字一起编码。
实际使用中,Unicode 编码常用于解决中文乱码问题:当系统之间字符集不一致导致显示乱码时,把内容转为 Unicode 编码传输可以保证不丢失信息;网页与程序源码中也常用它来表示特殊字符,避免文件编码问题。本工具的编码与解码均支持 emoji 等四字节字符(会按 UTF-16 代理对处理),解码时自动识别输入格式,全部计算在你的浏览器本地完成,不向服务器上传任何数据。
常见问题
1. Unicode和UTF-8有什么区别?
Unicode 是字符集,负责给每个字符分配唯一的编号(码点);UTF-8、UTF-16 等是编码方式,负责规定这个编号在计算机中如何存储为字节。可以打个比方:Unicode 是"户口本",给每个字符上户口编号,UTF-8 则是"存储方案",决定这个编号占几个字节、怎么排列。日常说"UTF-8 编码"时,本质是在说"用 UTF-8 方式存储 Unicode 字符"。
2. 为什么中文会显示成 \u4e2d\u6587 这样的乱码?
这不是乱码,而是中文的 Unicode 转义形式。\u4e2d 表示码点为 4E2D 的字符,也就是"中"。它常出现在程序源码、接口返回的 JSON 数据或压缩后的前端代码中,目的是避免文件编码问题。把这类内容粘贴到本工具的解码框中,即可一键还原为可读的中文。
3. 为什么一个 emoji 会编码成两组 \uXXXX?
emoji 等字符的码点超出了基本多文种平面(BMP,码点大于 FFFF),无法用一个 4 位十六进制数表示,因此需要按 UTF-16 的代理对机制拆成高位和低位两组编码,例如 😀 会被编码为 \ud83d\ude00。本工具在编码与解码时均已正确处理代理对的拆分与合并,可放心使用。
4. "仅中文等非ASCII字符"和"全部字符"有什么区别?
选择"仅中文等非ASCII字符"时,英文、数字等 ASCII 字符会原样保留,只有中文、全角符号等被转换,结果可读性较好,是最常用的方式;选择"全部字符"时,连字母数字也会被编码(如 a 变成 \u0061),常用于简单的文本混淆。两种方式均可完整还原。
5. 在线Unicode转换会上传我的数据吗?
不会。本工具的编码与解码均在你的浏览器本地计算完成,输入内容不会发送到任何服务器,断网状态下同样可以正常使用。
- CopyRight © 2025 r239.com All Rights Reserved
- 渝ICP备2024043669号-2